AI-инфраструктура HuaKun: станция, сервер или кластер?
Выбор локального инференса, PCIe, модульных платформ и кластеров по памяти, программной совместимости, параллельности и пилоту.
Определите нагрузку для AI-сервиса
Выбор AI-инфраструктуры начинается с требований к сервису. Помощник по базе знаний, обработка изображений и обучение модели требуют разных ресурсов. Укажите точную версию модели, размеры входных и выходных данных, число пользователей, параллельные запросы и допустимую задержку. Для интерактивного сервиса могут быть важны время до первого ответа и работа под длительной нагрузкой; для пакетной обработки — срок завершения. Учитывайте размещение конфиденциальных данных и требования к работе бизнеса при сбое. Это даёт проверяемый профиль сервиса до сравнения оборудования.
Память и программная совместимость
Веса модели занимают лишь часть памяти. Для инференса также нужны память под контекст, промежуточные результаты, среду выполнения и параллельные запросы. Квантование оценивают вместе с качеством ответов и совместимостью. Оперативная память хоста, память ускорителя и ёмкость дисков — разные ресурсы. Программный стек ускорителя должен поддерживать операторы модели, фреймворк и версии контейнеров. Пилот должен проверить реальные запросы, длинный контекст и пиковую параллельную нагрузку. Обучение дополнительно требует хранения состояния оптимизатора и контрольных точек, поэтому пригодность конфигурации инференса для обучения проверяют отдельно.
От рабочей станции к модульному серверу
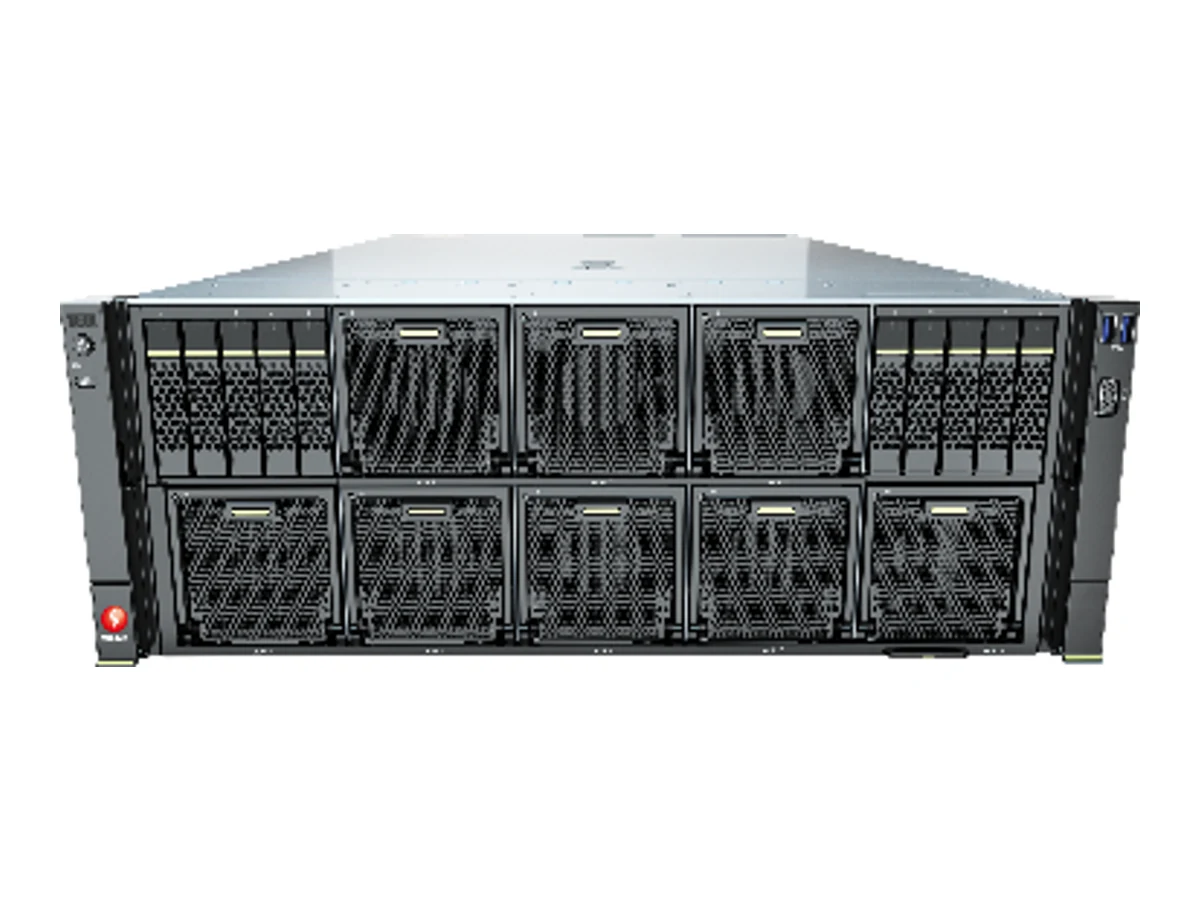
AT600W можно рассмотреть для локальной работы с моделями. Для централизованного PCIe-инференса AT225 и AT225 B2 сравнивают отдельно: AT225 использует DDR4, B2 поддерживает до шести карт Atlas 300I Duo. AT9508 G3 — платформа 4U для установки до десяти двухслотовых ускорителей. Для модульных систем производитель указывает восемь NPU A2G4 в AT548 Inference и восемь A2G3 в AT548 Training. Даже при указанных связях с названиями AT3500 G3 и AT800 (Model 9000) A2 необходимо проверить конкретное поколение модулей.
Выбор масштаба
Кластер — больше, чем дополнительные ускорители. Разбиение модели, межсоединения, чтение данных и запись контрольных точек взаимосвязаны. Переход к AT900 A2 PoDc или SuperPoD требует проверки многоузлового ПО и готовности питания и охлаждения. TGDataXAI относится к процессам приложений, TGHCI — к управлению ресурсами, HKStor — к хранению; роли включают в архитектуру.
| Нагрузка | Исходный вариант |
|---|---|
| Локальная интерактивная работа | Рабочая станция и пилот приложения |
| Общий сервис инференса | PCIe или модульный сервер инференса |
| Многоузловое обучение | Проект кластера, межсоединений и площадки |
От модели к результату приложения
Для помощника по базе знаний включите в пилот исходные документы, обновление индекса, права доступа и ссылки на источники в ответах. Быстрый ответ не делает ошибочные или недоступные пользователю сведения приемлемыми. Примеры вопросов от владельца бизнес-процесса должны охватывать нужные языки, отсутствие информации и неоднозначные запросы. Определите порядок передачи нерешённого запроса и ведения эксплуатационного журнала. Это позволяет отдельно оценить качество приложения и нагрузку сервера, включить оба аспекта в приёмку и замечать ухудшение после запуска.
От пилота к задаче закупки
В пилоте фиксируют качество ответов, задержку, параллельную нагрузку, использование памяти, неудачные запросы и поведение при восстановлении. Результаты сравнивают при одинаковой модели, числовой точности и контексте. SOFCONS может объединить AI-автоматизацию, поставку серверов, источники знаний, права доступа и интеграцию с действующими системами в одном проекте. В предложении должны быть версии ПО, конфигурация оборудования, условия питания и охлаждения, сценарии приёмки. Приложите к запросу модель и профиль пользователей, чтобы пилот соответствовал бизнес-задаче и условиям эксплуатации.
Спланируем вашу ИТ-инфраструктуру
Обсудим выбор серверов и платформ под ваши приложения, AI-задачи и требования дата-центра.
Подробнее о технологиях
Применение на практике
HuaKun Kunpeng/ARM: план перехода корпоративных приложений
Практическое руководство по совместимости ARM, выбору пилота и поэтапному переходу — от бинарных файлов до восстановления.
Жидкостное охлаждение HuaKun: от сервера к проекту площадки
Сравнение охлаждающих пластин, распыления и погружения по совместимости узлов, сети, отводу тепла, U/OU и обслуживанию.